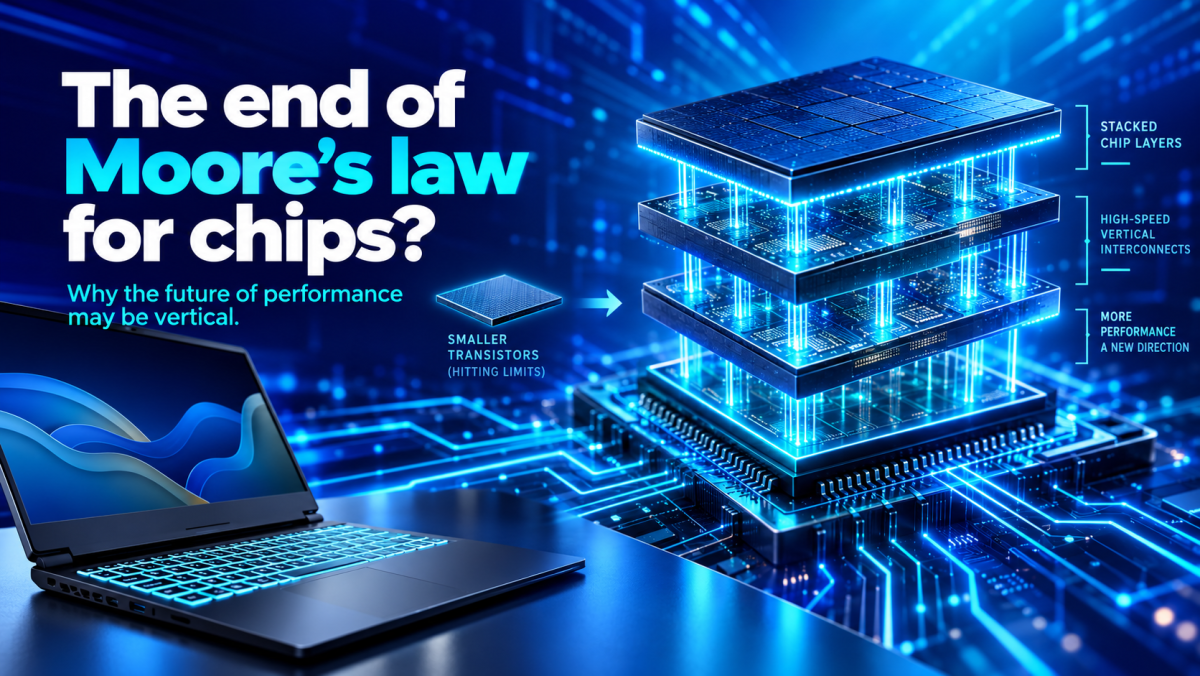
Pendant des décennies, l'industrie des puces a suivi une formule relativement simple : réduire la taille des transistors, en placer davantage sur la même puce et les ordinateurs deviennent plus rapides et efficaces.
Ce principe est connu sous le nom de la loi de Moore.
Mais un problème émerge : nous approchons des limites physiques de la miniaturisation des transistors.
Des chercheurs de l'Université de l'Illinois Urbana-Champaign ont récemment démontré une nouvelle approche pour construire des puces silicium. Leurs recherches suggèrent que l'avenir des puces informatiques ne repose peut-être pas uniquement sur des transistors encore plus petits.
Peut-être devrions-nous plutôt aller vers la hauteur.
Et cela pourrait avoir des implications majeures pour les futurs processeurs dans les ordinateurs portables, les stations de travail et les systèmes d'IA.
Qu'est-ce que la loi de Moore exactement?
En 1965, Gordon Moore, cofondateur d'Intel, a observé que le nombre de composants pouvant être placés économiquement sur un circuit intégré augmentait très rapidement.
Plus tard, la loi de Moore a été particulièrement associée à l'idée que le nombre de transistors sur une puce doublait environ tous les deux ans.
Ce n'est pas une loi naturelle. C'était plutôt un objectif que l'industrie des puces a remarquablement réussi à maintenir pendant des décennies.
Les transistors plus petits ont permis de construire des CPU et GPU de plus en plus complexes sur approximativement la même surface.
Plus de transistors signifiaient plus de puissance de calcul.
Et les processus de fabrication plus petits rendaient généralement les puces plus économes en énergie.
Cela a fonctionné admirablement pendant des décennies.
Mais les transistors modernes sont désormais extrêmement petits.
À un certain point, vous ne pouvez pas continuer à réduire indéfiniment les structures. Les chercheurs de l'Illinois soulignent que la miniaturisation supplémentaire est de plus en plus limitée par les propriétés du silicium lui-même et finalement par la mécanique quantique.
La question devient donc : que faisons-nous si la réduction de taille ne peut plus progresser?
Construire plus haut, pas plus petit
Une solution semble presque évidente.
S'il n'y a pas assez d'espace horizontalement, utilisez la troisième dimension.
Les processeurs modernes sont traditionnellement construits comme des structures de transistors extrêmement complexes en deux dimensions. Bien sûr, il existe déjà diverses formes de technologie 3D, comme la mémoire empilée et le 3D V-Cache.
Mais ces approches produisent généralement d'abord des dies ou des wafers séparés, puis les connectent ensemble.
Les chercheurs de l'Illinois travaillent sur quelque chose de plus ambitieux : l'intégration 3D monolithique.
Les couches de transistors sont produites directement les unes sur les autres.
Voyez la différence comme une ville qui ne s'étend plus avec de nouvelles banlieues, mais qui construit des gratte-ciel.
L'équipe de recherche a démontré plusieurs couches de transistors intégrés verticalement et a construit notamment des circuits logiques et des cellules de mémoire SRAM.
Ce qui est particulièrement intéressant, c'est que ces couches peuvent être interconnectées beaucoup plus étroitement que dans les techniques conventionnelles de puces 3D.
C'est important, car les processeurs modernes ne sont pas seulement limités par la vitesse de commutation des transistors.
Le déplacement des données consomme aussi de plus en plus de temps et d'énergie.
Un processeur ne doit pas seulement calculer, mais aussi communiquer
Cela devient particulièrement important pour les charges de travail en IA.
Un CPU ou GPU peut contenir une énorme quantité de puissance de calcul, mais toutes ces unités de calcul ont constamment besoin de données.
Les données doivent se déplacer entre les cœurs, le cache, la mémoire et autres composants du système.
Et cela consomme de l'énergie.
En plaçant les composants verticalement plus près les uns des autres, les connexions électriques peuvent être plus courtes.
Cela peut potentiellement offrir :
- une plus grande bande passante;
- une latence plus faible;
- une consommation d'énergie réduite;
- plus de puissance de calcul par millimètre carré.
Pour les CPU, GPU et accélérateurs IA, c'est particulièrement intéressant.
Cela souligne également quelque chose que nous observons depuis longtemps chez SKIKK : les performances informatiques dépendent de moins en moins d'une seule spécification et de plus en plus de l'architecture complète.
Un CPU plus rapide ne rend pas automatiquement un ordinateur plus rapide.
La bande passante mémoire compte. Le cache compte. Le stockage compte. Le refroidissement compte. Les limites de puissance comptent.
Et de plus en plus souvent, l'efficacité de la communication entre les différents composants compte aussi.
Les architectures de puces 3D peuvent éventuellement appliquer ce principe jusqu'au niveau des transistors.
Pourquoi ne le faisons-nous pas déjà massivement?
La chaleur.
Ou plus précisément : la chaleur pendant le processus de fabrication.
La fabrication de transistors silicium conventionnels haute performance nécessite normalement des températures très élevées.
Ce n'est pas un problème pour la première couche.
Mais si vous souhaitez ensuite produire une nouvelle couche de transistors directement sur les circuits existants, cela crée un problème sérieux : les connexions métalliques existantes ne peuvent pas supporter ces hautes températures.
L'équipe de recherche a donc développé une approche différente.
Au lieu de former du silicium cristallin nouveau directement sur l'électronique existante, les chercheurs produisent des couches de silicium ultrafines séparément et les placent ensuite sur la wafer.
Cela permet d'ajouter de nouvelles couches de transistors sans endommager les circuits sous-jacents.
Et en théorie, vous pouvez ensuite répéter ce processus.
Et encore.
La loi de Moore est-elle alors morte?
Pas nécessairement.
Peut-être que le sens du mot scaling change surtout.
Pendant des décennies, le développement de puces signifiait principalement :
Des transistors plus petits = plus de transistors par puce.
À l'avenir, cela pourrait de plus en plus souvent signifier :
Plus de couches = plus de transistors sur la même surface.
Au lieu de rendre les transistors infiniment plus petits, les fabricants de puces peuvent donc aller de plus en plus haut.
Nous voyons déjà ce changement.
La NAND flash utilise déjà depuis des années des structures 3D. Les processeurs modernes utilisent de plus en plus des chiplets. La High Bandwidth Memory empile les mémoires. AMD utilise un cache empilé avec 3D V-Cache.
La direction est claire : l'industrie s'éloigne progressivement de l'idée qu'une seule puce énorme et plate est toujours la meilleure solution.
N'attendez pas un gratte-ciel de puces dans votre prochain ordinateur portable
Il y a une grande différence entre la recherche réussie et la production de masse.